Laravel-Updates ohne Ausfallzeit: Wie wir unsere Deployments umgestellt haben
Wie wir Laravel-Deployments mit Coolify auf Rolling Updates umgestellt haben: keine Ausfallzeit, keine verlorenen Sessions mehr.
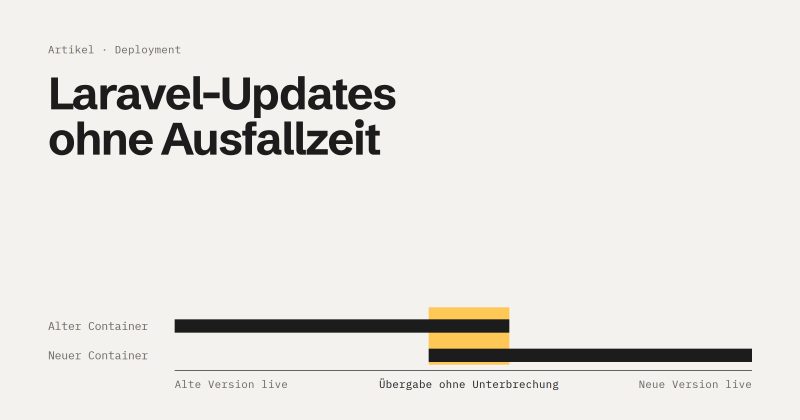
Jedes Deployment bedeutete bei uns früher: Die Anwendung ist kurz weg. Mal ein paar Sekunden, manchmal bis zu einer Minute. Für ein internes Tool klingt das harmlos, für die Leute, die gerade damit arbeiten, ist es das nicht. In diesem Artikel beschreibe ich, wie unser Deployment früher aussah, warum es Probleme gemacht hat und wie wir heute mit Coolify ohne Ausfallzeit ausliefern.
Wie es früher lief
Unser Ablauf war ein klassisches Setup mit GitLab CI und Docker. Die Pipeline war auf bestimmte Branches beschränkt, bei uns auf den Testing- und den Main-Branch. Sobald dort eine Änderung gemergt wurde, startete ein Runner und hat:
- das Docker-Image gebaut,
- die Abhängigkeiten installiert,
- das Frontend gebaut,
- das fertige Image in unser Docker-Hub-Repository geschoben.
Danach schickte der Runner einen Webhook an unseren Server. Dafür musste dort ein Port offen sein, hinter dem ein Deployment-Script lauschte. Dieses Script hat das neueste Image gezogen, die Container gestoppt und neu gestartet und anschließend die üblichen Befehle ausgeführt: Migrationen, Config-Cache, Storage-Link und so weiter.
Das Problem
Zwischen „alter Container gestoppt" und „neuer Container bereit" lag eine Lücke. In dieser Zeit war die Anwendung nicht erreichbar, je nach Umfang des Deployments mehrere Sekunden bis zu einer Minute.
Schlimmer als die Ausfallzeit selbst war, was sie für die Nutzer bedeutete: Wer gerade mitten in einem Vorgang war, verlor seine Session und musste von vorn anfangen. Wenn das bei einem längeren Formular passiert, ist das mehr als ärgerlich.
Dazu kam ein offener Port auf dem Server, nur damit die Pipeline das Deployment anstoßen konnte. Das ist eine zusätzliche Angriffsfläche, die man eigentlich nicht haben möchte.
Wie es heute läuft
Heute nutzen wir Coolify. Am Ablauf für uns Entwickler hat sich fast nichts geändert: Wir pushen auf Testing oder Main, und das Deployment startet.
Im Hintergrund passiert aber etwas anderes. Coolify baut das Image direkt auf dem Server, der Umweg über Docker Hub entfällt. Danach führt Coolify ein Rolling Update aus:
- Der neue Container wird mit dem neuen Image gestartet.
- Der alte Container läuft währenddessen weiter und beantwortet alle Anfragen.
- Coolify prüft, ob der neue Container gesund ist (Health Check).
- Erst dann leitet der Proxy neue Anfragen an den neuen Container weiter.
- Zum Schluss wird der alte Container gestoppt und entfernt.
Zu keinem Zeitpunkt gibt es also eine Phase, in der kein Container Anfragen annimmt. Für die Nutzer passiert das Update unbemerkt.
Das Schöne daran: Ich musste dafür selbst kaum etwas bauen. Das Umschalten des Traffics übernimmt Coolify automatisch.
Datenbank-Migrationen
Die Migrationen laufen beim Deployment im neuen Container, nachdem das Image gebaut wurde. So ist die Datenbank auf dem neuen Stand, bevor der neue Container den Traffic übernimmt.
Laufende Jobs und Queues
Was passiert mit Jobs, die gerade abgearbeitet werden, wenn der alte Container gestoppt wird? Hier hilft uns das Basis-Image von Server Side Up. Es unterstützt einen sogenannten Graceful Shutdown: Bevor der Container stoppt, bekommt er Zeit, laufende Vorgänge abzuschließen. Bei uns sind das [30] Sekunden. Ein Job, der gerade läuft, wird also nicht sofort mitten im Ablauf abgebrochen.
Was schiefgehen kann: externe Abhängigkeiten
Einmal konnten wir gar nicht deployen. Beim Bauen des Images sollte eine Abhängigkeit geklont werden, und die war schlicht nicht erreichbar. Ohne sie kein Image, ohne Image kein Deployment.
Meine Lehre daraus: Ein Deployment sollte möglichst nicht davon abhängen, dass jede externe Quelle im richtigen Moment erreichbar ist. Die Versionen sind über die Lock-Datei ohnehin festgelegt und ändern sich beim Deployment nicht. Es ergibt also wenig Sinn, sie bei jedem Build neu aus dem Netz zu ziehen. Besser ist es, die Abhängigkeiten mit auszuliefern oder zwischenzuspeichern.
Wenn doch etwas schiefgeht: Rollback
Coolify behält eine bestimmte Anzahl älterer Images. Wenn eine neue Version Probleme macht, kann man direkt in Coolify auf ein vorheriges Image zurückrollen, ohne neu bauen zu müssen.
Mein wichtigster Tipp für den Einstieg: der Port
Wenn eine Laravel-Anwendung in Coolify nicht erreichbar ist, liegt es nach meiner Erfahrung meistens am Port. Im Dockerfile steht er vielleicht schon, aber Coolify muss ihn ebenfalls kennen, und zwar an zwei Stellen:
- Beim Service selbst unter „Ports Exposes", bei uns
8080. - Bei der Domain, indem man den internen Port an die Domain anhängt, zum Beispiel
https://example.com:8080. Der Port taucht später nicht in der öffentlichen URL auf. Er sagt dem Proxy nur, wohin er intern weiterleiten soll.
Fehlt eine der beiden Angaben, läuft der Container zwar, aber die Seite bleibt unerreichbar. Und weil auf den ersten Blick alles grün aussieht, sucht man den Fehler oft an der falschen Stelle.
Fazit
Die Umstellung auf Rolling Updates mit Coolify hat bei uns zwei Probleme auf einmal gelöst: keine Ausfallzeit mehr beim Deployment und kein offener Port mehr für Webhooks. Für die Nutzer ist ein Update heute nicht mehr spürbar. Und für uns Entwickler ist der Ablauf so einfach geblieben wie vorher: pushen, fertig.